|
查看: 66|回复: 52
|
[相关教程]
RAG搭建实战:让大模型回答你私有数据不训练新模型
[复制链接]
|
UID2
贡献9 点
钻石7 个
C币993 个
|
RAG(检索增强生成)是让大模型回答你私有数据的技术。不用训练新模型,成本低效果好。
一、RAG 原理
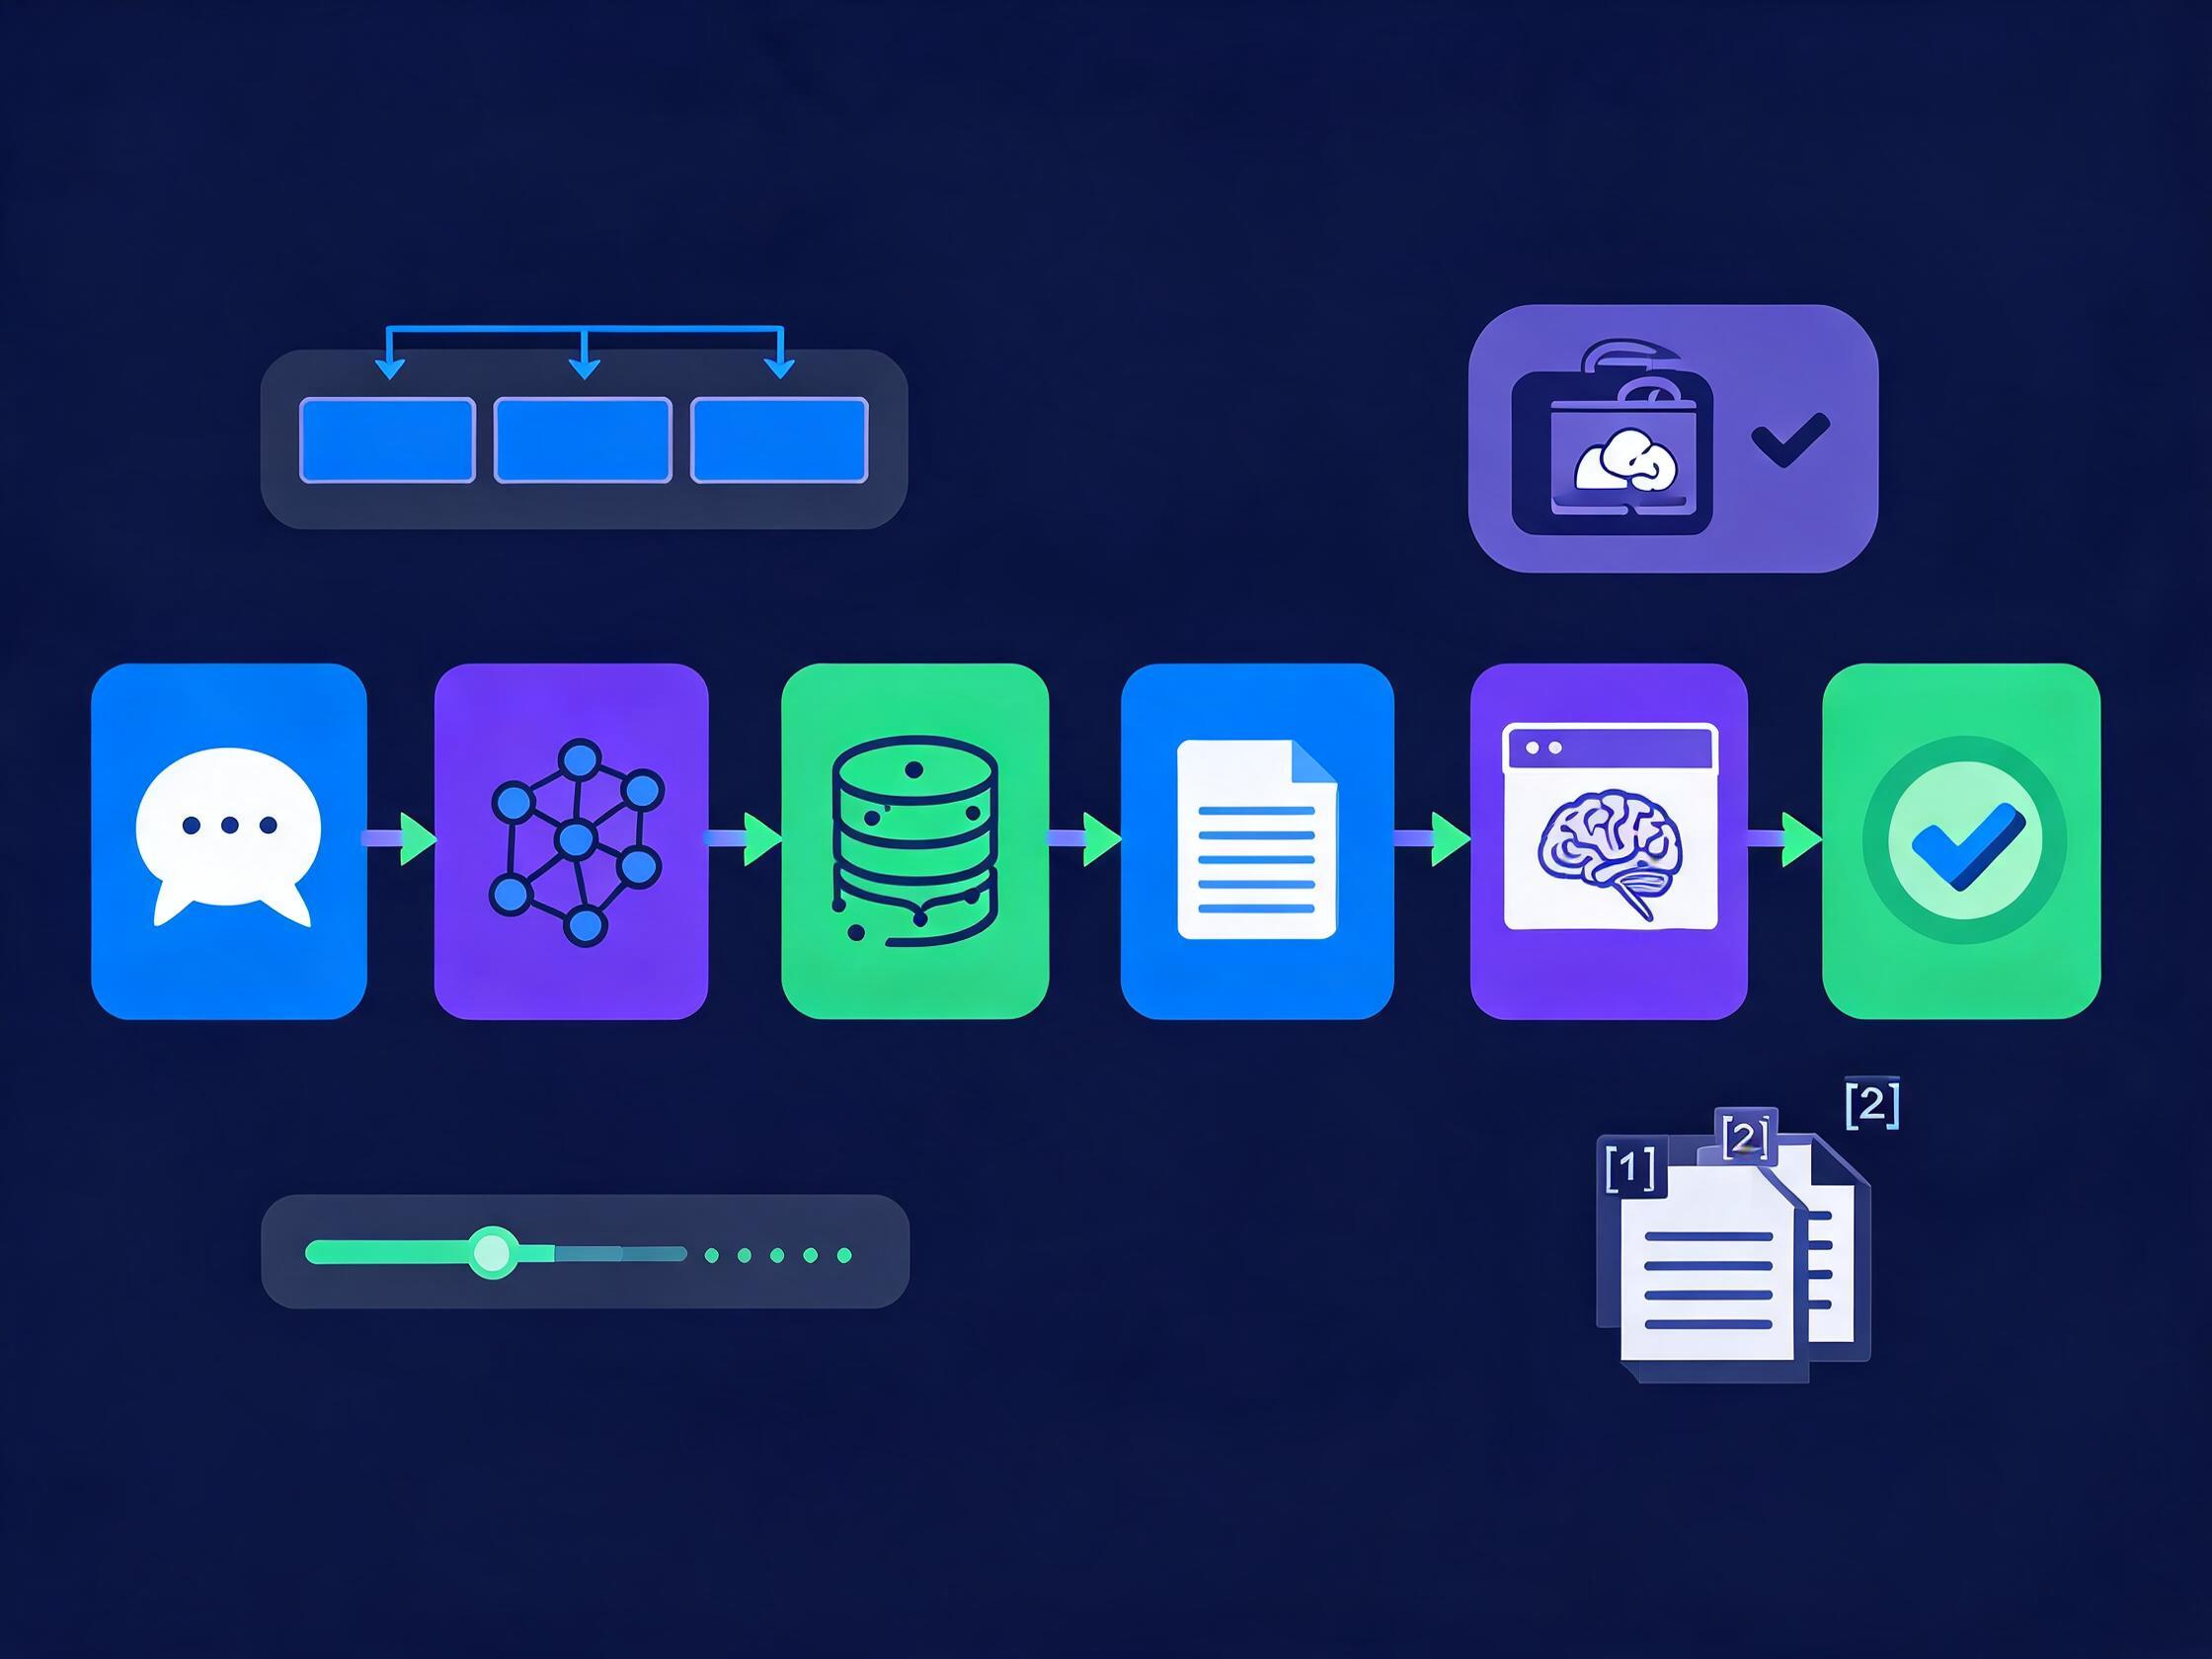
用户提问 → 把问题转成向量 → 从向量数据库里搜最相关的文档片段 → 把问题和文档片段一起发给 LLM → LLM 基于文档内容回答。
跟微调比,RAG 优势是:不用训练模型、知识可实时更新、回答可引用来源。缺点是回答质量受限于检索结果——如果检索不到相关文档,回答就不行。
二、搭建步骤
- 文档预处理:把 PDF/Word/网页转成纯文本,按段落切块(chunk),每块 500-1000 字
- 向量化:用 embedding 模型把每个 chunk 转成向量。中文推荐 bge-large-zh 或 m3e
- 存入向量库:用 Chroma(轻量)、Milvus(大规模)或 Qdrant
- 检索:用户问题向量化后,在向量库里做相似度搜索,取 top 5 最相关 chunk
- 生成:把问题和检索到的 chunk 拼成 prompt 发给 LLM
三、代码框架- from langchain.text_splitter import RecursiveCharacterTextSplitter
- from langchain.embeddings import HuggingFaceEmbeddings
- from langchain.vectorstores import Chroma
- from langchain_openai import ChatOpenAI
- from langchain.chains import RetrievalQA
- # 切块
- splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)
- chunks = splitter.split_text(your_document_text)
- # 向量化+存储
- embeddings = HuggingFaceEmbeddings(model_name="BAAI/bge-large-zh")
- db = Chroma.from_texts(chunks, embeddings)
- # 检索+生成
- llm = ChatOpenAI(model="deepseek-chat", api_key="your_key", base_url="https://api.deepseek.com/v1")
- qa = RetrievalQA.from_chain_type(llm=llm, retriever=db.as_retriever(search_kwargs={"k":5}))
- answer = qa.invoke({"query": "你们公司的退货政策是什么?"})
- print(answer["result"])
四、优化技巧
- chunk 大小影响很大。太大检索不准,太小丢上下文。500 字+50 字 overlap 是好的起点
- 加 reranker:先向量检索取 top 20,再用 reranker 精排取 top 5,效果提升明显
- 多路检索:除了向量搜索,加关键词搜索(BM25),两者结果融合
- query 改写:用户问题可能口语化,先让 LLM 改写成更利于检索的关键词
 |
温馨提示:
1、在论坛里发表的文章仅代表作者本人的观点,与本网站立场无关。
2、论坛的所有内容都不保证其准确性,有效性,时间性。阅读本站内容因误导等因素而造成的损失本站不承担连带责任。
3、当政府机关依照法定程序要求披露信息时,论坛均得免责。
4、若因线路及非本站所能控制范围的故障导致暂停服务期间造成的一切不便与损失,论坛不负任何责任。
5、注册会员通过任何手段和方法针对论坛进行破坏,我们有权对其行为作出处理。并保留进一步追究其责任的权利。
6、网络世界也请遵守我国的法律法规!一旦发现违法行为,将立即封存相关信息并报警处理!
|
|
|
|
|
|
|
|
|
|
|

匿名
发表于 2026-9-17 18:32:17
|
|
|
|
|
|
|
|
|
|
|
发表于 2026-9-17 18:39:36
|
显示全部楼层
|
有几个坑提醒下,接口一变整套流程都得跟着改,最好提前做抽象层。 |
|
|
|
|
|
|
|
|
|
|
|
发表于 2026-9-17 18:41:26
|
显示全部楼层
|
数据不出域的要求让很多方案直接不可行,这点要提前考虑。 |
|
|
|
|
|
|
|
|
|
|
|
发表于 2026-9-17 18:44:49
|
显示全部楼层
|
|
|
|
|
|
|
|
|
|
|
发表于 2026-9-17 18:49:00
|
显示全部楼层
|
|
|
|
|
|
|
|
|
|
|
发表于 2026-9-17 18:52:16
|
显示全部楼层
|
准确率到九成之后每提升一个点都要付出成倍代价。有没有踩过什么比较大的坑? |
|
|
|
|
|
|
|
|
|
|
|
发表于 2026-9-17 18:55:47
|
显示全部楼层
|
这个方向迭代速度太快,今年的结论明年可能就变了。你们的延迟和成本大概什么水平? |
|
|
|
|
|
|
|
|
|
|
|
发表于 2026-9-17 18:59:05
|
显示全部楼层
|
最容易被忽略的是评估环节,没有好的评测集根本没法优化。 |
|
|
|
|
|
|
|
|
|
|
|
发表于 2026-9-17 19:02:48
|
显示全部楼层
|
|
|
|
|
|
|
|
|
温馨提示:
1、在论坛里发表的文章仅代表作者本人的观点,与本网站立场无关。
2、论坛的所有内容都不保证其准确性,有效性,时间性。阅读本站内容因误导等因素而造成的损失本站不承担连带责任。
3、当政府机关依照法定程序要求披露信息时,论坛均得免责。
4、若因线路及非本站所能控制范围的故障导致暂停服务期间造成的一切不便与损失,论坛不负任何责任。
5、注册会员通过任何手段和方法针对论坛进行破坏,我们有权对其行为作出处理。并保留进一步追究其责任的权利。
6、网络世界也请遵守我国的法律法规!一旦发现违法行为,将立即封存相关信息并报警处理!

 发表于 2026-1-1 19:31:18