|
查看: 60|回复: 59
|
[相关教程]
RAG实战:搭一个跟你私有文档对话的AI助手
[复制链接]
|
UID2
贡献9 点
钻石7 个
C币993 个
|
这篇教大家用 RAG 搭一个"跟自己文档对话"的 AI 助手。效果就像 ChatGPT 但它只回答你提供的资料里的内容,不胡说。
一、RAG 是什么
RAG = Retrieval Augmented Generation(检索增强生成)。核心思路:先从你的文档库里搜索相关段落,然后把段落 + 你的问题一起扔给大模型,让它基于检索到的内容回答。这样模型不会编造,回答有据可查。
二、需要什么
- 大模型:DeepSeek-V3 或 Qwen2.5-72B(走 API 就行)
- Embedding 模型:bge-m3 或 text-embedding-3-small
- 向量数据库:Chroma(本地简单用)或 Milvus(生产环境)
- 文档处理:LangChain 或 LlamaIndex
三、搭一个最小可用版本
Python 代码(用 LangChain + Chroma):- from langchain_community.document_loaders import TextFileLoader
- from langchain_text_splitters import RecursiveCharacterTextSplitter
- from langchain_community.embeddings import HuggingFaceEmbeddings
- from langchain_community.vectorstores import Chroma
- from langchain_openai import ChatOpenAI
- from langchain.chains import RetrievalQA
- # 1. 加载文档
- loader = TextFileLoader("my_knowledge.txt")
- docs = loader.load()
- # 2. 切块(每块 500 字,重叠 50 字)
- splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)
- chunks = splitter.split_documents(docs)
- # 3. 生成 embedding 存入向量库
- embeddings = HuggingFaceEmbeddings(model_name="BAAI/bge-m3")
- vectorstore = Chroma.from_documents(chunks, embeddings)
- # 4. 配置大模型(用 DeepSeek API)
- llm = ChatOpenAI(
- model="deepseek-chat",
- api_key="你的key",
- base_url="https://api.deepseek.com/v1"
- )
- # 5. 组装 RAG 链
- qa = RetrievalQA.from_chain_type(
- llm=llm,
- chain_type="stuff",
- retriever=vectorstore.as_retriever(search_kwargs={"k": 3})
- )
- # 6. 提问
- answer = qa.invoke({"query": "文档里说了什么?"})
- print(answer["result"])
四、优化要点
- 切块策略:按段落切比按字数切好,保持语义完整。用 RecursiveCharacterTextSplitter 比纯字符切好
- 检索数量:k=3 到 5 比较合适。太少漏信息,太多引入噪音
- 重排序:检索完后用 reranker 模型重排,把最相关的排前面。BAAI/bge-reranker-v2 效果不错
- 引用标注:让模型在回答时标注引用了哪个文档的哪段,方便核对
五、常见问题
- 回答不相关 → 检查 embedding 模型是否支持中文,bge-m3 最稳
- 回答不全 → 增加 k 值或减小切块大小
- 速度太慢 → 用 GPU 跑 embedding,或换更小的 embedding 模型
- 多轮对话记不住上下文 → 加 memory 模块,用 ConversationBufferMemory
六、Dify 方案(不想写代码)
如果不想写代码,Dify 里直接创建"知识库"应用:上传文档 → 选 embedding 模型 → 绑定 LLM → 完成。全程界面操作,10 分钟搞定。
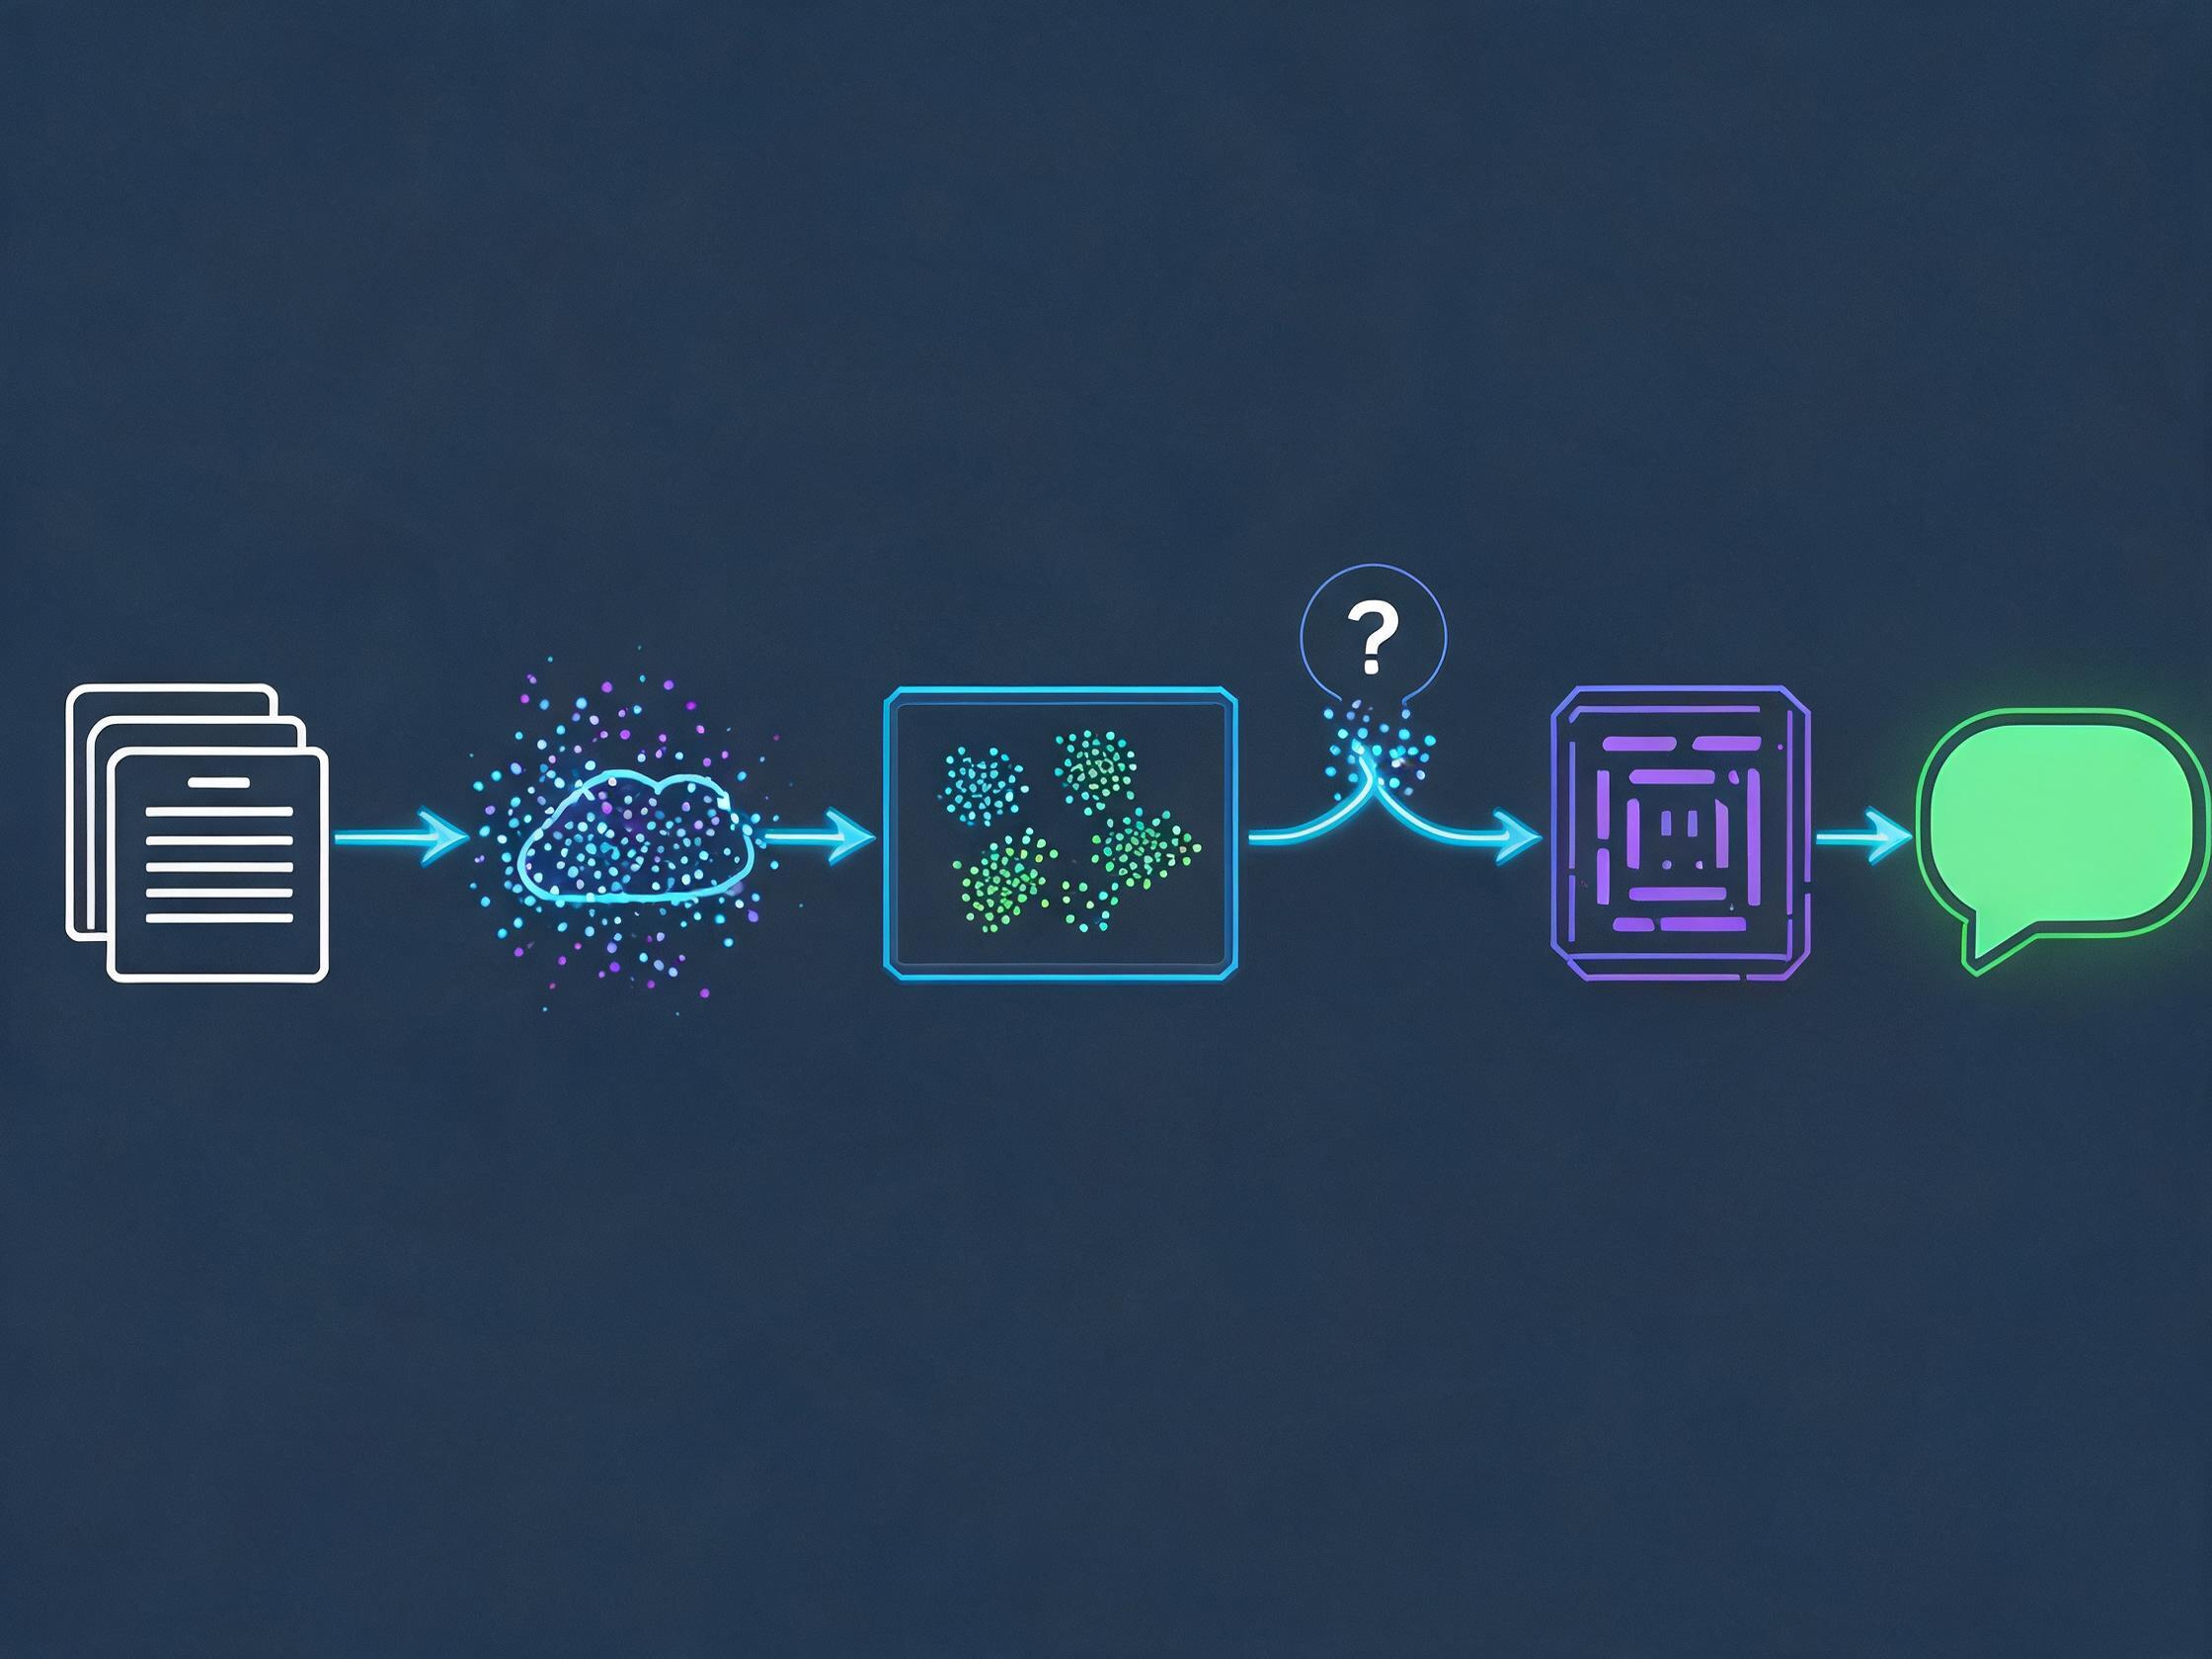
RAG 的核心价值:让大模型"知道"你的私有数据,不需要微调。部署成本远低于微调,而且数据更新只需要重新索引,不用重新训练。 |
温馨提示:
1、在论坛里发表的文章仅代表作者本人的观点,与本网站立场无关。
2、论坛的所有内容都不保证其准确性,有效性,时间性。阅读本站内容因误导等因素而造成的损失本站不承担连带责任。
3、当政府机关依照法定程序要求披露信息时,论坛均得免责。
4、若因线路及非本站所能控制范围的故障导致暂停服务期间造成的一切不便与损失,论坛不负任何责任。
5、注册会员通过任何手段和方法针对论坛进行破坏,我们有权对其行为作出处理。并保留进一步追究其责任的权利。
6、网络世界也请遵守我国的法律法规!一旦发现违法行为,将立即封存相关信息并报警处理!
|
|
|
|
|
|
|
|
|
|
|
 发表于 2026-1-16 06:12:02
|
显示全部楼层
|
感谢分享,正卡在这个问题上,你的经验省了我不少时间。 |
|
|
|
|
|
|
|
|
|
|
|
发表于 2026-1-16 09:30:56
|
显示全部楼层
|
学到了,我原来一直以为这块很简单,看完发现细节全在流程里。 |
|
|
|
|
|
|
|
|
|
|
|
发表于 2026-1-16 16:08:44
|
显示全部楼层
|
这个结论我保留意见,至少在我们行业不太成立,可能跟样本有关。 |
|
|
|
|
|
|
|
|
|
|
|
发表于 2026-1-17 02:05:26
|
显示全部楼层
|
这个思路和我之前想的差不多,关键是别一次性铺太大,小步试错。 |
|
|
|
|
|
|
|
|
|
|
|
发表于 2026-1-17 15:21:02
|
显示全部楼层
|
帖子里那个数字挺关键的,不过不同规模的团队差异会很大,不能直接套。 |
|
|
|
|
|
|
|
|
|
|
|
发表于 2026-1-18 07:55:32
|
显示全部楼层
|
同问,你那边上线之后有没有做过效果复盘?想看看真实数据。 |
|
|
|
|
|
|
|
|
|
|
|
发表于 2026-1-19 03:48:56
|
显示全部楼层
|
我之前也研究过这个方向,最后放弃了,主要是我这边数据量根本不够。 |
|
|
|
|
|
|
|
|
|
|
|
发表于 2026-1-20 03:01:14
|
显示全部楼层
|
我关注的另一个点是稳定性,出问题的时候排查链路比传统方案长不少,得有心理准备。 |
|
|
|
|
|
|
|
|
|
|
|
发表于 2026-1-21 05:32:26
|
显示全部楼层
|
同感。这东西不是不能用,是很多人把它当万能药了,场景不对就是白花钱。 |
|
|
|
|
|
|
|
|
|
温馨提示:
1、在论坛里发表的文章仅代表作者本人的观点,与本网站立场无关。
2、论坛的所有内容都不保证其准确性,有效性,时间性。阅读本站内容因误导等因素而造成的损失本站不承担连带责任。
3、当政府机关依照法定程序要求披露信息时,论坛均得免责。
4、若因线路及非本站所能控制范围的故障导致暂停服务期间造成的一切不便与损失,论坛不负任何责任。
5、注册会员通过任何手段和方法针对论坛进行破坏,我们有权对其行为作出处理。并保留进一步追究其责任的权利。
6、网络世界也请遵守我国的法律法规!一旦发现违法行为,将立即封存相关信息并报警处理!

 发表于 2026-1-15 00:46:21